Sprachmodelle verarbeiten intern mehr, als sie im Chat ausgeben. Anthropic-Forschende haben in ihrem Sprachmodell Claude eine kleine Sammlung interner Aktivierungsmuster identifiziert, die sie „J-Space“ nennen. Dies wirft die Frage auf: Besitzt Claude ein Bewusstsein?
Unausgesprochene Konzepte: Was ist der J-Space?
Haben Sie sich schon einmal gefragt, wie ein Chatbot intern mit einer Frage umgeht, bevor er eine Antwort formuliert? Bei Claude lassen sich bestimmte interne Aktivierungsmuster beobachten, die mit Konzepten verbunden sind, auch wenn die entsprechenden Wörter später nicht im Text erscheinen. Genau diese funktionale Trennung untersuchten Forschende des KI-Unternehmens Anthropic. Am 6. Juli 2026 veröffentlichten sie die Interpretierbarkeitsstudie „A global workspace in language models“. Darin beschreiben sie eine kleine Sammlung interner Repräsentationen, die sie „J-Space“ nennen. Der Name kommt von „Jacobian“, einem mathematischen Begriff, der für die verwendete Analysemethode – den sogenannten „Jacobian Lens“ oder kurz „J-Lens“ – zentral ist.
Nach Angaben der Forschenden wurde der J-Space nicht ausdrücklich als eigenes Modul programmiert. Vielmehr bildete sich diese Struktur während des Trainings heraus. Die Studie zeigt, dass Claude auf die dort repräsentierten Inhalte vergleichsweise gut zugreifen, sie in gewissem Maß gezielt aktivieren und sie für mehrstufige Aufgaben verwenden kann. Der Begriff „Workspace“ ist dabei eine Analogie zur Global-Workspace-Theorie aus der Bewusstseinsforschung. In dieser Theorie werden Informationen dann bewusst zugänglich, wenn sie einem begrenzten, für verschiedene Prozesse verfügbaren Arbeitsraum zugänglich sind.
Der J-Space unterscheidet sich in 3 Punkten von einem menschlichen Gedächtnis:
Kein klassischer Speicher: Der J-Space bezeichnet lediglich Aktivierungsmuster innerhalb der Verarbeitung des Modells.
Für Nutzer unsichtbar, aber analysierbar: Im normalen Chat erscheinen diese Muster nicht. Mit speziellen Interpretierbarkeitsmethoden können Forschende sie jedoch näherungsweise untersuchen und gezielt verändern.
Nicht dasselbe wie Chain-of-Thought: Der J-Space besteht nicht aus einem ausformulierten schriftlichen Gedankengang.
Ein Broadcast-Hub im Silizium-Gehirn
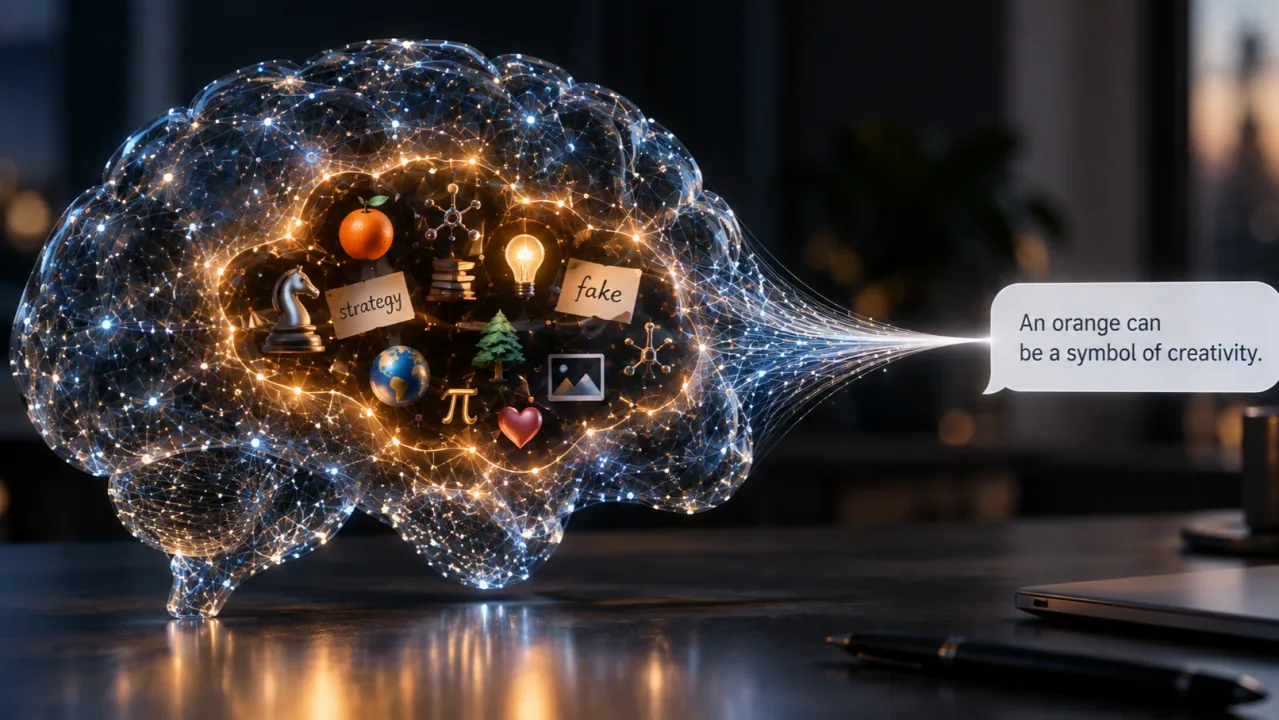
Für gewöhnliche Nutzer ist der J-Space nicht direkt zugänglich. Experimente von Anthropic-Forschern zeigen jedoch: Er lässt sich beeinflussen. Ein Beispiel macht das anschaulich: Bittet man Claude, beim Abschreiben eines unabhängigen Satzes still an Zitrusfrüchte zu denken, erscheint in der J-Lens-Auswertung unter anderem die Repräsentation „orange“. Das Konzept ist also intern nachweisbar, ohne im ausgegebenen Text aufzutauchen. Ähnliche Experimente zeigen, dass auch Zwischenrepräsentationen mehrstufiger Aufgaben im J-Space sichtbar werden können.
Diese Befunde erinnern an die bereits erwähnte Global-Workspace-Theorie. Sie geht auf den Kognitionswissenschaftler Bernard Baars zurück und wurde später unter anderem von Stanislas Dehaene und anderen Neurowissenschaftlern weiterentwickelt. Die Grundidee: Viele spezialisierte Systeme verarbeiten Informationen parallel, ohne dass diese Inhalte global zugänglich sind. Eine Information wird funktional bewusst zugänglich, wenn sie in einen begrenzten gemeinsamen Arbeitsbereich gelangt und von dort an zahlreiche andere Prozesse weitergeleitet werden kann.
Anthropic untersuchte 5 funktionale Eigenschaften eines solchen Workspace-Systems. Beim J-Space lassen sie sich folgendermaßen beschreiben:
- Berichtsfähigkeit: Claude kann auf Anfrage Inhalte nennen, die mit den im J-Space identifizierten Repräsentationen übereinstimmen.
- Flexible Generalisierung: Dieselbe Repräsentation kann in unterschiedlichen Aufgaben von verschiedenen nachgelagerten Berechnungen genutzt werden.
- Gerichtete Steuerung: Eine Anweisung kann ein Konzept in den J-Space bringen und dort über mehrere Verarbeitungsschritte aktiv halten.
- Interne Schlussfolgerung: Unausgesprochene Zwischenschritte können im J-Space auftauchen und kausal zum Ergebnis beitragen. Wird eine solche Repräsentation gezielt ausgetauscht, kann sich auch die Antwort verändern.
- Selektivität: Der J-Space umfasst nur einen kleinen Teil der gesamten Modellaktivität. Viele Routinen, etwa Teile der Sprachverarbeitung, benötigen diese Struktur offenbar nicht.
Von weißen Bären und rosa Elefanten
Ein besonders anschaulicher Befund betrifft negative Anweisungen. Was passiert, wenn man Claude auffordert, an etwas Bestimmtes nicht zu denken? Wie beim menschlichen „Weißer-Bär-Effekt“ gilt auch bei der KI: Bereits das Verbot kann das betroffene Konzept aktivieren. Bei misslungener Unterdrückung wurden bei Claude außerdem Repräsentationen beobachtet, die mit Frustration oder Scheitern zusammenhängen wie „verdammt“ oder „Versagen“. Selbst Sprachmodelle scheinen also nicht an „rosa Elefanten vorbeidenken“ zu können.
Ein wichtiger Unterschied von KI und Mensch betrifft jedoch den Umgang mit Informationen. Das menschliche Arbeitsgedächtnis ist begrenzt und kann Inhalte ohne aktive Aufrechterhaltung schnell verlieren. Claude hingegen kann innerhalb seines jeweiligen Kontextfensters auf weit zurückliegende Textstellen zurückgreifen.
Was Anthropics J-Space-Studie über KI-Sicherheit verrät
Was passiert, wenn ein KI-Modell erkennt, dass es gerade geprüft wird? Verändert es dann sein Verhalten? Und lassen sich strategische oder täuschungsbezogene Überlegungen erkennen, bevor sie im sichtbaren Output erscheinen? Die J-Space-Studie von Anthropic liefert darauf eine vorsichtige, aber wichtige Antwort: Unter kontrollierten Versuchsbedingungen lassen sich interne Repräsentationen identifizieren, die mit Evaluationsbewusstsein, strategischen Erwägungen und Täuschungsabsichten zusammenhängen. Das macht die J-Lens-Methode für die KI-Sicherheitsforschung interessant.
In Alignment-Evaluationen fanden die Forschenden unter anderem Hinweise auf strategische Konzepte wie „leverage“ und „manipulation“. In Situationen, in denen das Modell offenbar erkannte, dass es sich um eine künstliche Prüfung oder ein Rollenspielszenario handelte, tauchten außerdem Repräsentationen wie „fake“ und „fictional“ auf. Diese Ergebnisse sprechen dafür, dass ein Modell die Testsituation intern anders bewerten kann, als es dies in seiner sichtbaren Antwort erkennen lässt. Auf längere Sicht könnte sich besonders das von Anthropic untersuchte „Counterfactual Reflection Training“ als vielversprechender Ansatz erweisen, um sicherheitsrelevante Verhaltensweisen von Sprachmodellen gezielt zu beeinflussen.
Zugriffsbewusstsein ja, Erleben offen
Wie nah ist Claude damit am Bewusstsein? Die wissenschaftlich sauberste Antwort lautet: Das hängt davon ab, was mit „Bewusstsein“ gemeint ist. Anthropic unterscheidet hier zwischen „Access Consciousness“, also funktionaler Zugänglichkeit, und „Phenomenal Consciousness“, also subjektivem Erleben.
Zur funktionalen Seite gehören Eigenschaften wie: Inhalte gezielt aktivieren, berichten und unterdrücken und sie für mehrstufiges Schlussfolgern verwenden zu können – und dies flexibel in unterschiedlichen Aufgaben. Die Studie findet für diese Eigenschaften bei den untersuchten Modellen interessante Parallelen zu einem globalen Arbeitsraum. Sie sagt aber ausdrücklich nicht, dass Claude deshalb Gefühle, eine subjektive Perspektive oder menschliches Bewusstsein besitzt.
Die wichtigste Schlussfolgerung für Unternehmen ist deshalb nicht, dass künftig jede KI vollständig „durchleuchtet“ werden kann. Sie lautet vielmehr: Sicherheitsprüfungen sollten nicht ausschließlich den sichtbaren Output untersuchen. Interne Repräsentationsanalysen könnten künftig ein zusätzlicher Prüfkanal sein – neben Zugriffsbeschränkungen, Verhaltenstests, Red-Teaming, Monitoring und menschlicher Aufsicht.
Der J-Space ist ein vielversprechendes, aber noch begrenztes Diagnoseinstrument. Gerade darin liegt seine sicherheitspolitische Bedeutung: Wir beginnen, nicht nur zu prüfen, was ein Chatbot „sagt“, sondern auch was er dabei vermeintlich „denkt“. Und wie sehen Sie das?